Referenzarchitekturen
LLM-Observability und Evaluations-Pipeline
Traces aus der Produktion speisen Online-Evals und ein Dataset; Offline-Evals sichern Prompt-Änderungen ab.
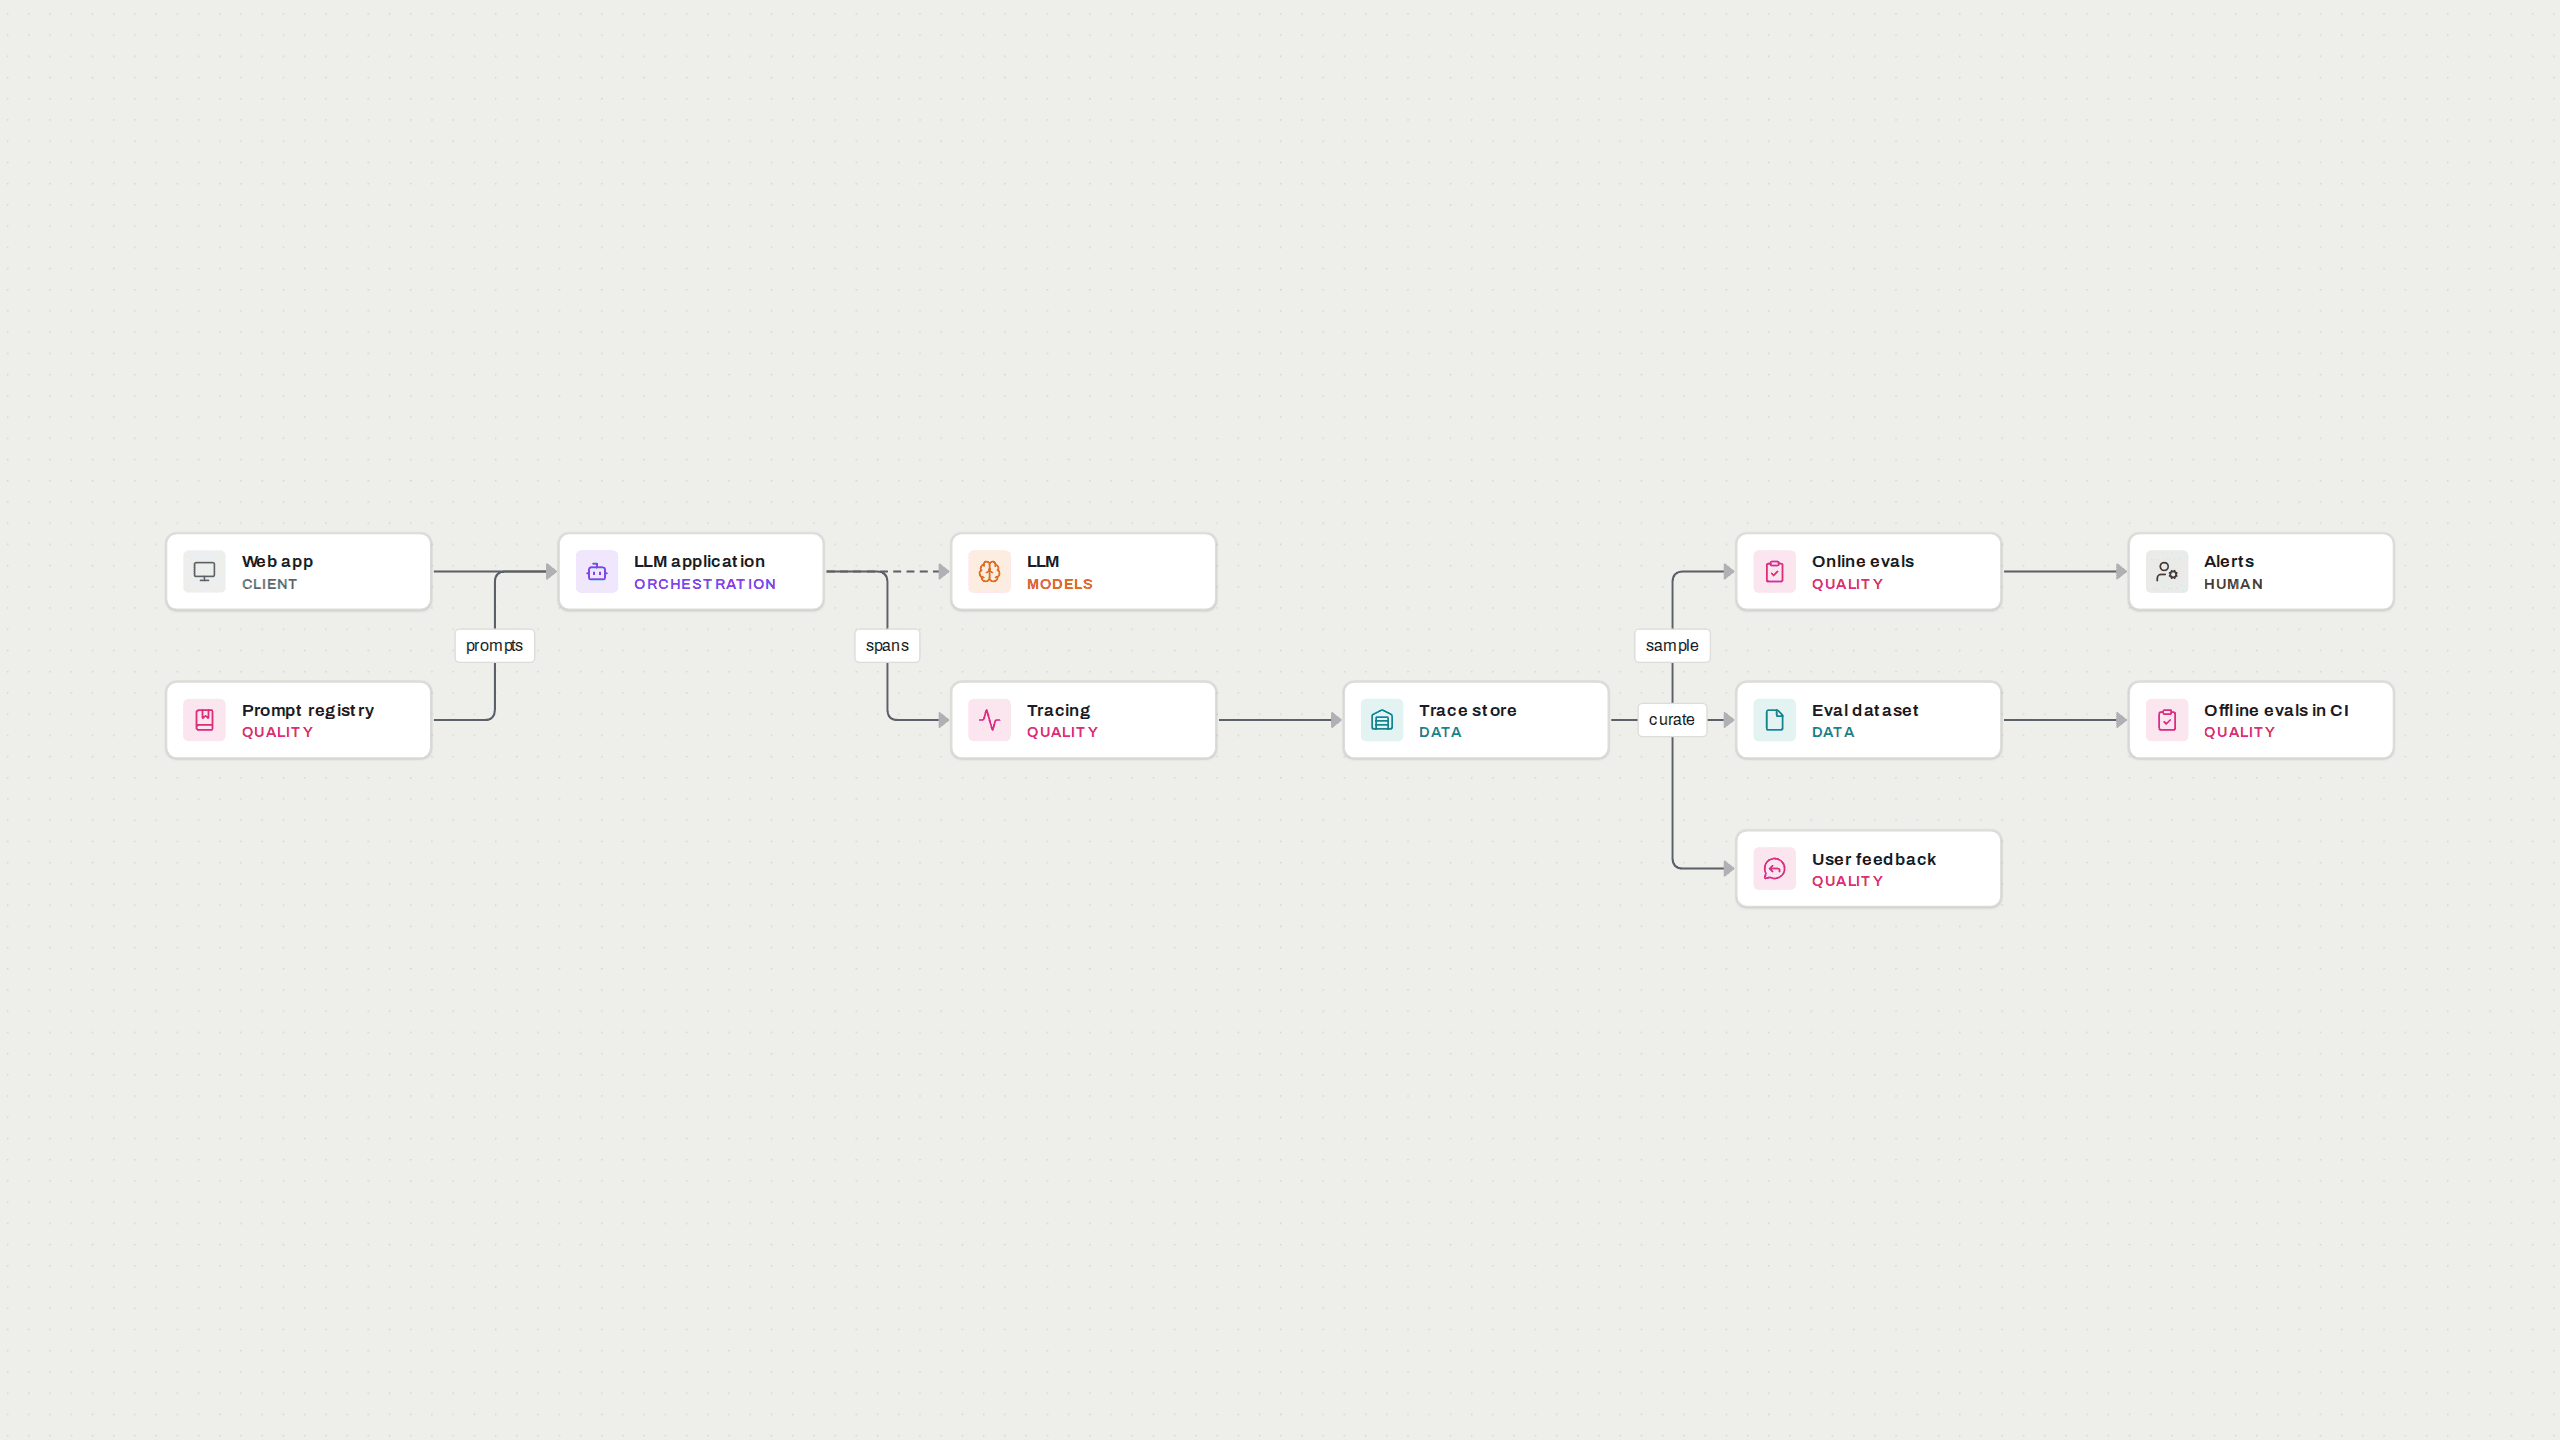
Eine LLM-Anwendung, die du nicht siehst, kannst du nicht verbessern. Diese Architektur zeichnet jeden Modellaufruf als Trace auf und speichert ihn. Online-Evals bewerten eine Stichprobe des Live-Verkehrs und lösen Alarme aus. Auffällige Traces und Nutzer-Feedback werden zu einem Evaluations-Dataset kuratiert. Offline-Evals lassen dieses Dataset in der CI laufen, sobald sich ein Prompt oder Modell ändert. So fällt eine Verschlechterung vor dem Release auf. Prompts liegen in einer Registry, nicht im Code.