Referenzarchitekturen
RAG-Architektur
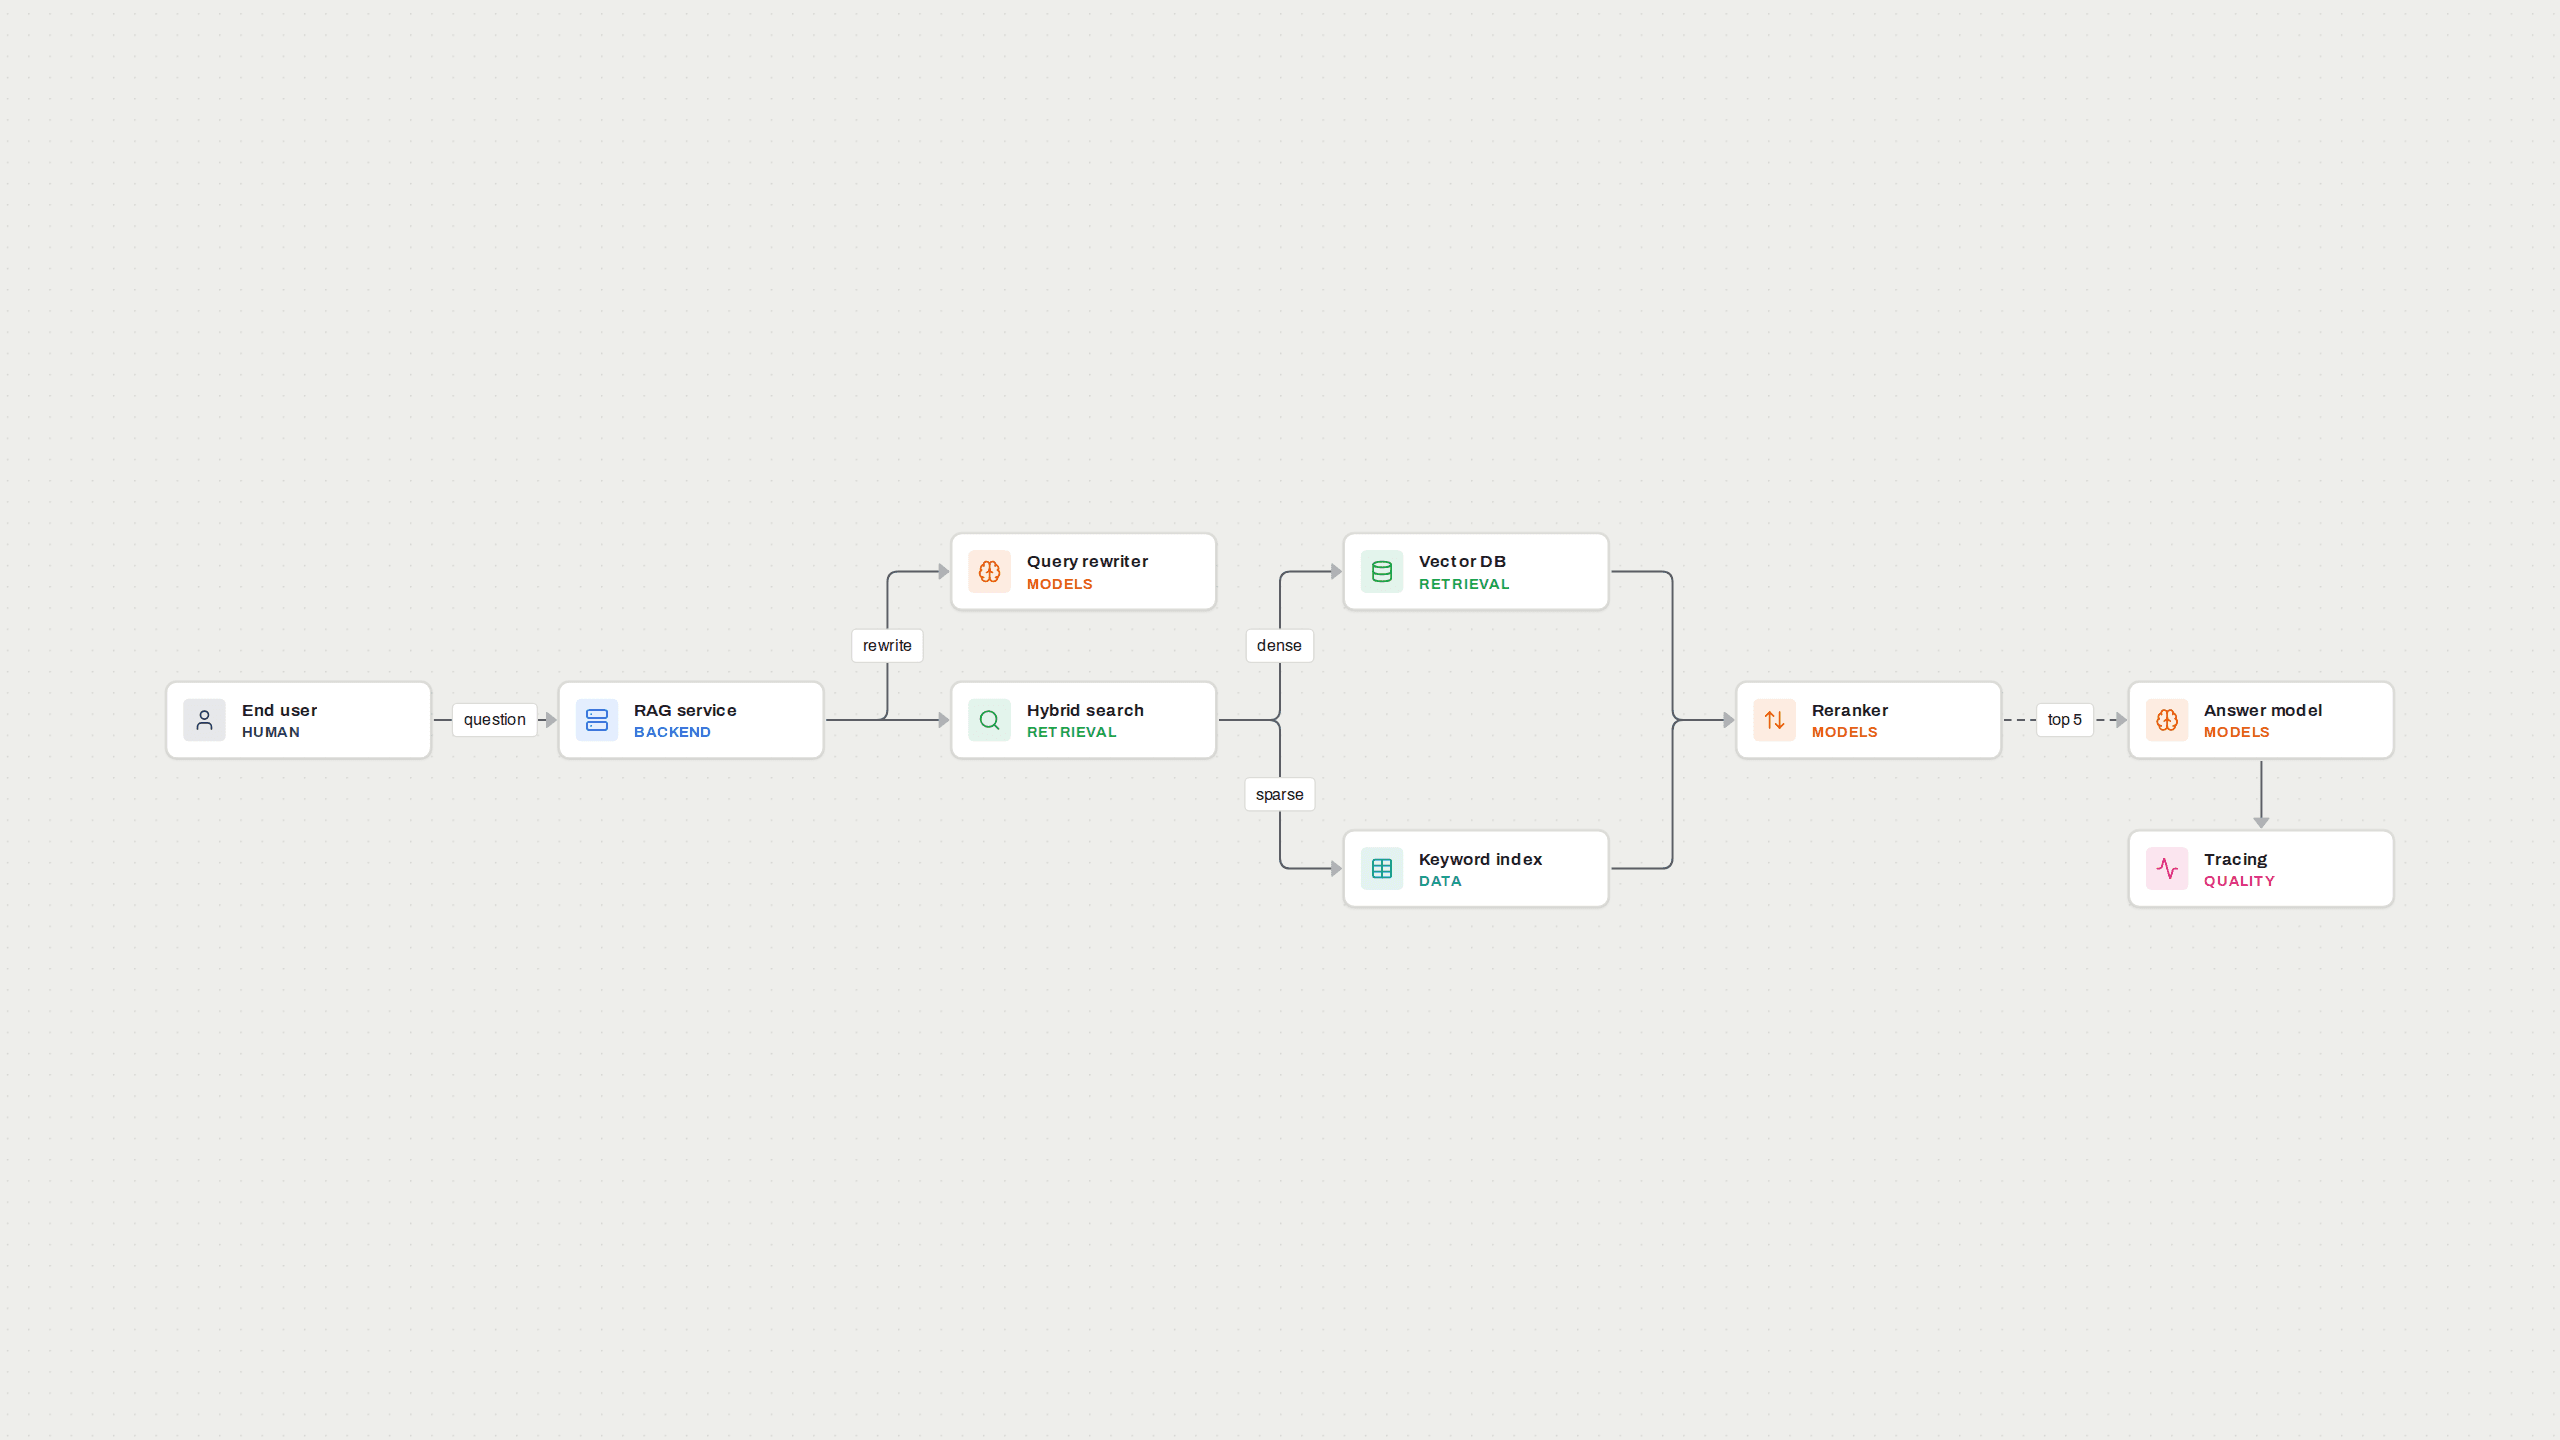
Retrieval-Augmented Generation in der Grundform: Dokumente einlesen, Kontext abrufen, Modell fragen.
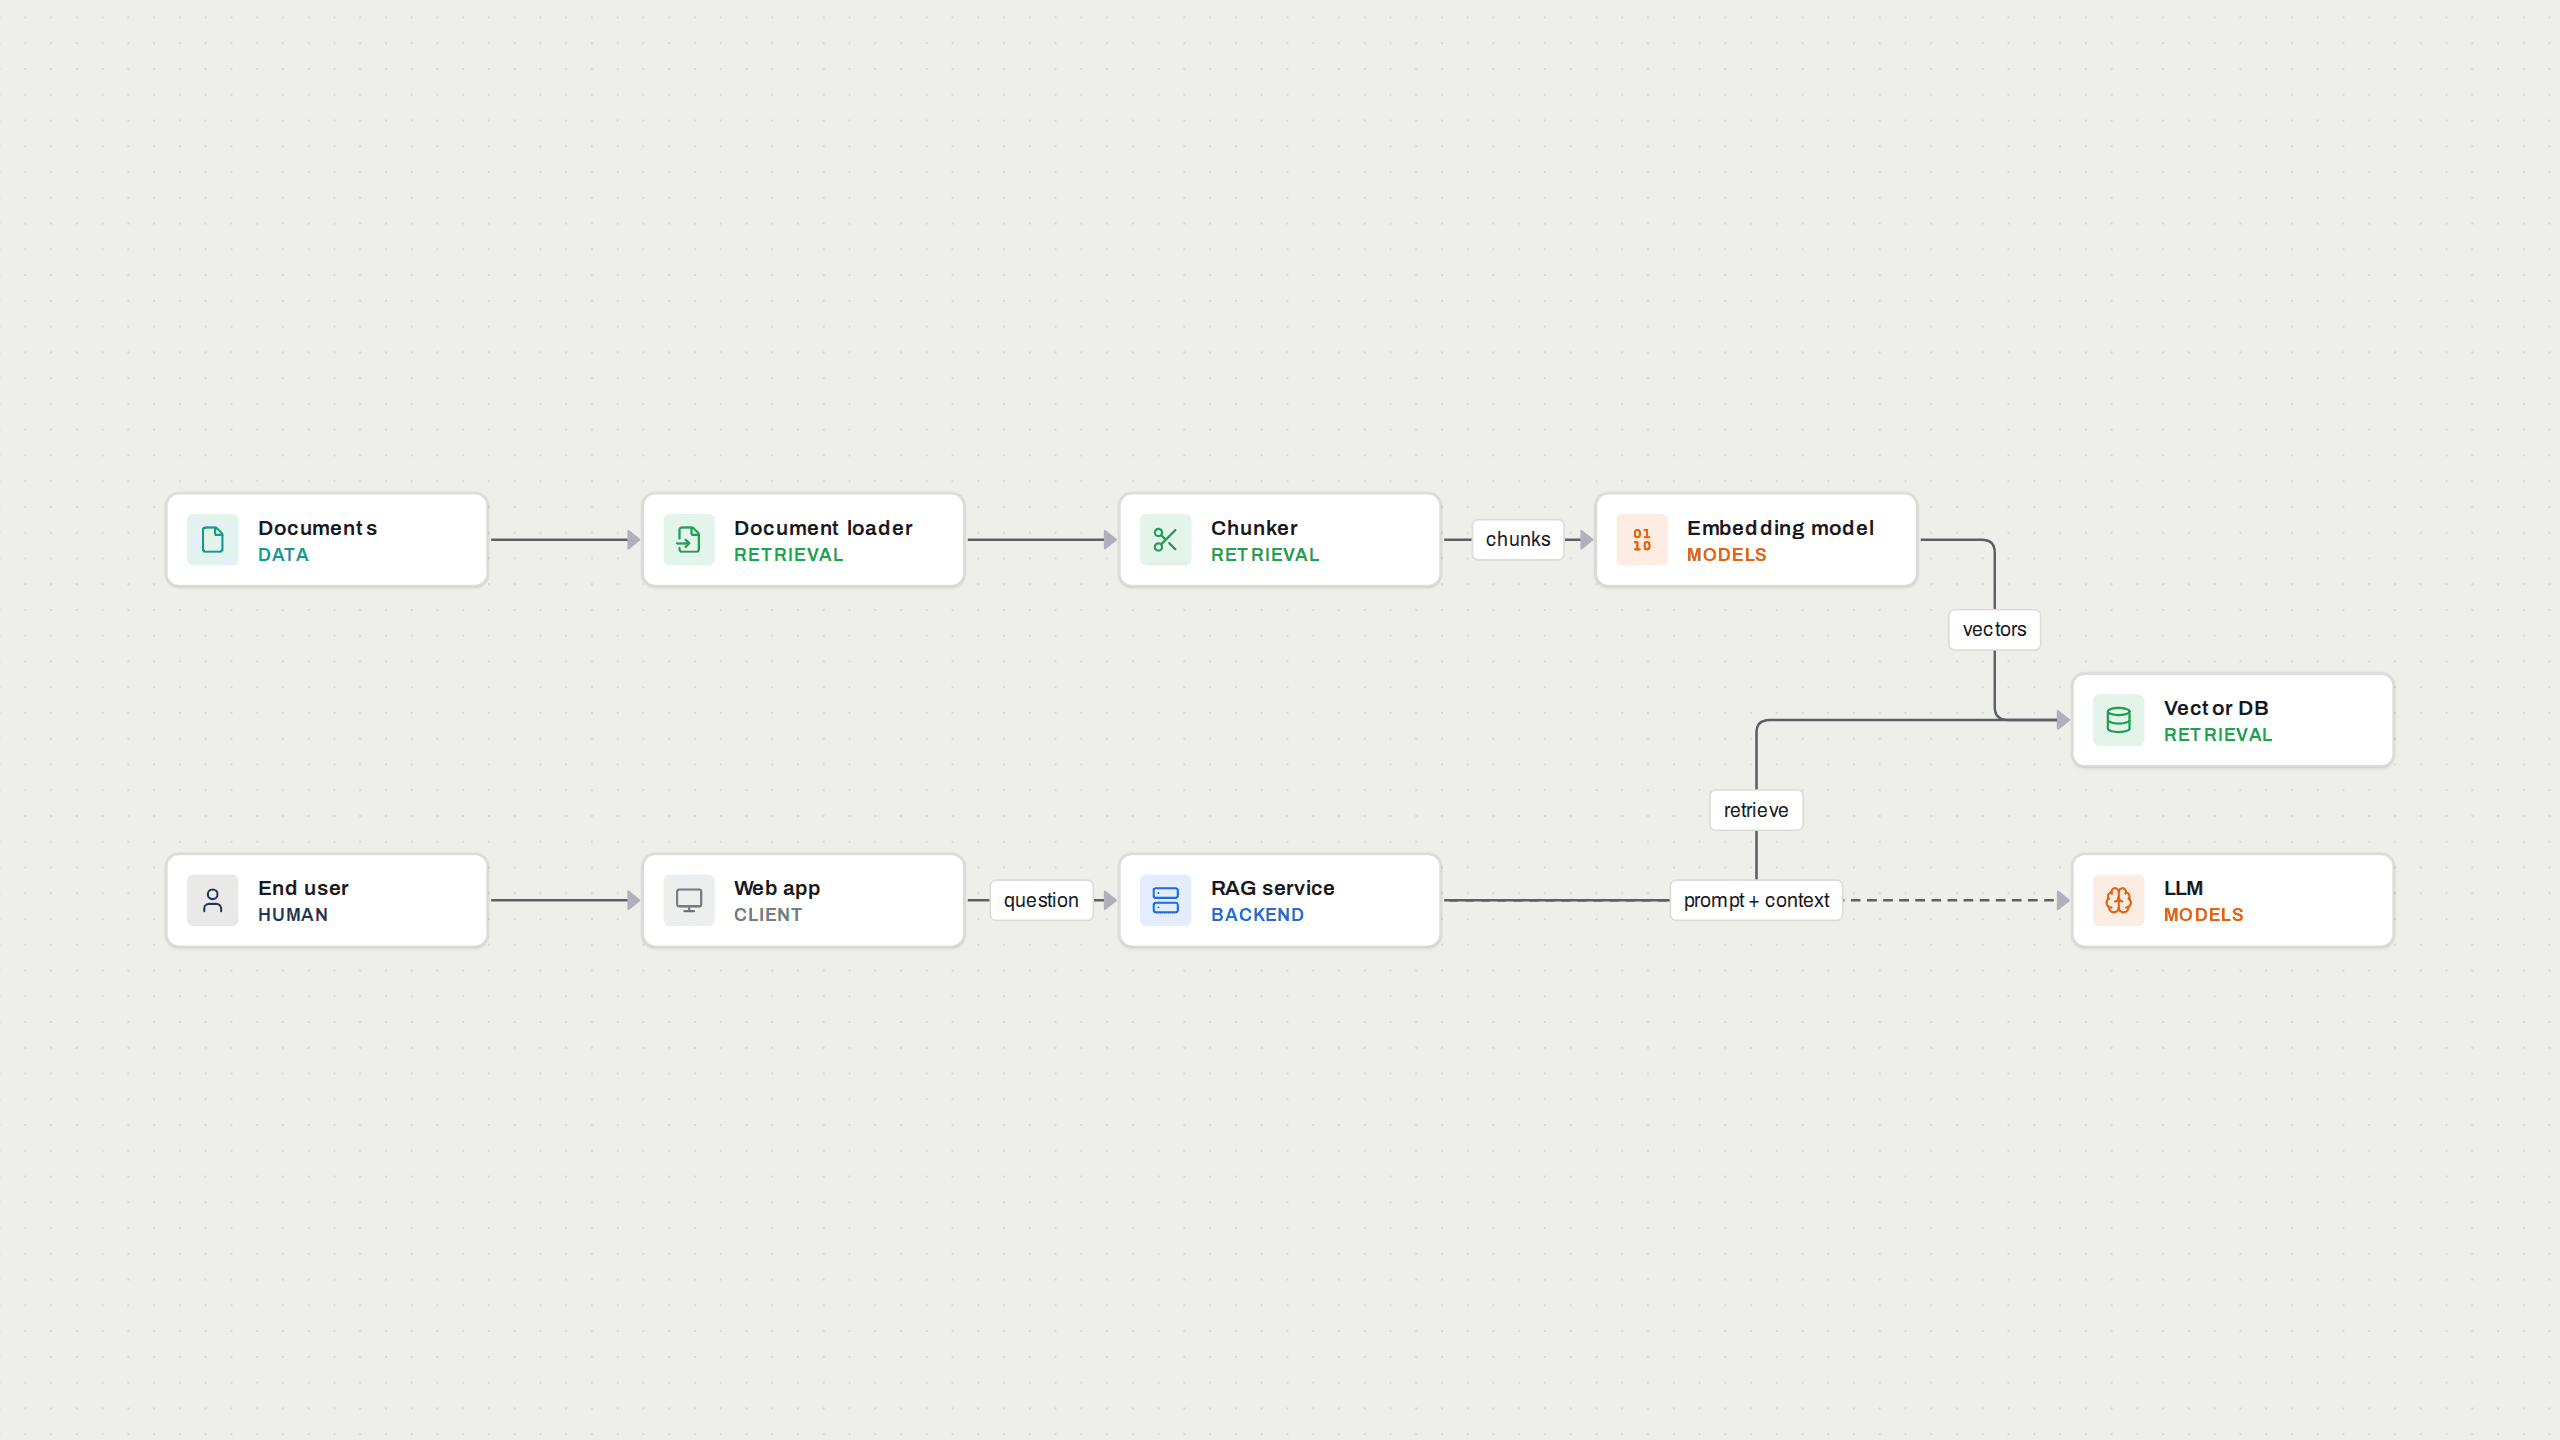
Ein RAG-System hat zwei Wege. Der Ingestion-Weg lädt Dokumente, teilt sie in Chunks, macht aus jedem Chunk mit einem Embedding-Modell einen Vektor und speichert ihn in einer Vector-DB. Der Abfrage-Weg nimmt die Frage des Nutzers, holt die ähnlichsten Chunks und schickt sie zusammen mit der Frage an das LLM. Das Diagramm zeigt, wie sich beide Wege in der Vector-DB treffen. Nimm es als Ausgangspunkt für jeden Assistenten, der aus deinen eigenen Dokumenten antworten soll.